有道翻译网页翻译适合直接处理一个完整网页。我的实际操作顺序很简单:打开网页翻译入口,把要处理的网页网址粘贴进去,确认语言方向后开始翻译,再在加载后的页面里对照原网页结构阅读译文。如果页面一直打不开,我会先判断网址本身能不能正常访问,再排查登录限制、动态加载和页面兼容问题。
如果电脑里还没有客户端,可以先从本站 有道翻译下载 页面进入对应版本。已经能够正常打开有道翻译的话,不需要重新安装,直接继续下面的网页翻译步骤。
30 秒完成一次网页翻译
- 打开有道翻译里的“网页翻译”入口。
- 复制需要翻译的完整网页网址。
- 把网址粘贴到网页翻译输入框。
- 确认源语言和目标语言,或者使用自动检测。
- 开始加载并翻译网页内容。
- 页面打开后,对照标题、正文、段落顺序和链接位置检查译文。
我第一次测试时不会直接拿结构特别复杂的网站,而是先选一篇普通新闻、博客或帮助文档。只要这种公开网页能够正常加载,就说明网页翻译入口本身基本正常;后面再测试登录页或大量动态内容的网站,更容易判断问题到底出在哪里。
有道翻译网页翻译入口在哪里
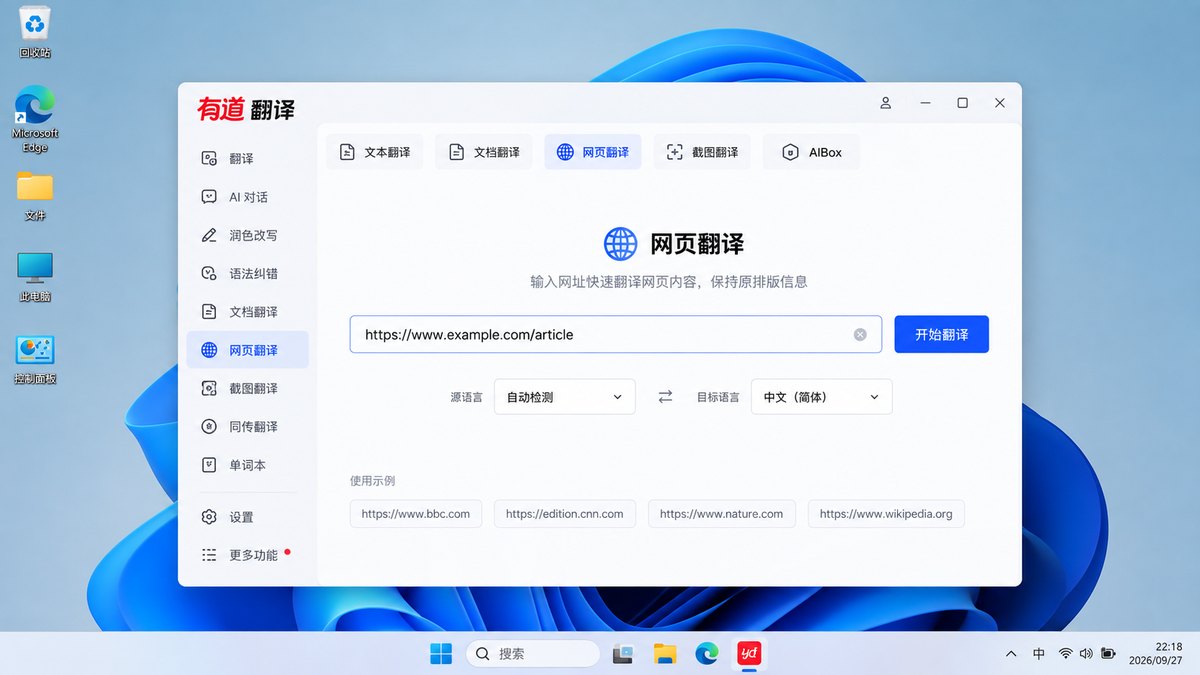
有道翻译把“网页翻译”单独作为一个功能入口。进入以后,我关注的不是普通文本输入框,而是能够接收网址的网页翻译区域。这里输入的是完整 URL,例如以 https:// 开头的网址,而不是复制网页正文。
如果当前界面没有直接显示网页翻译,我会先检查侧边栏或更多功能区域。不同版本的入口位置可能调整,但核心任务不会变化:提交网页地址,然后让系统加载网页内容进行翻译。
网址应该怎么输入
我会尽量使用浏览器地址栏里的完整网址,不自己删协议、参数或路径。最稳妥的做法是直接从目标网页地址栏复制,再粘贴到网页翻译输入框。
- 优先:完整的
https://...地址。 - 避免:只输入网站名称,例如只写域名品牌或网站简称。
- 避免:复制搜索结果标题,而不是网页地址。
- 注意:如果网址只有登录以后才能打开,后面可能出现加载不完整。
如果我粘贴网址以后完全没有反应,第一件事不是反复点击翻译,而是把这个网址重新放回普通浏览器打开一次。原网页本身都打不开时,网页翻译通常也不会正常工作。
整页翻译以后应该看什么
网页翻译完成后,我不会只看第一屏有没有译文。我会继续往下滚动,检查页面是否真的加载完整,尤其看标题、正文段落、列表、表格附近的文字有没有明显缺失。
- 标题:网页主标题有没有正常显示译文。
- 正文:中间段落有没有突然跳回原语言。
- 顺序:译文是否还跟着原网页的阅读顺序。
- 链接:按钮和链接位置有没有大面积错位。
- 长页面:继续往下滚动后,后半部分是否还能正常加载。
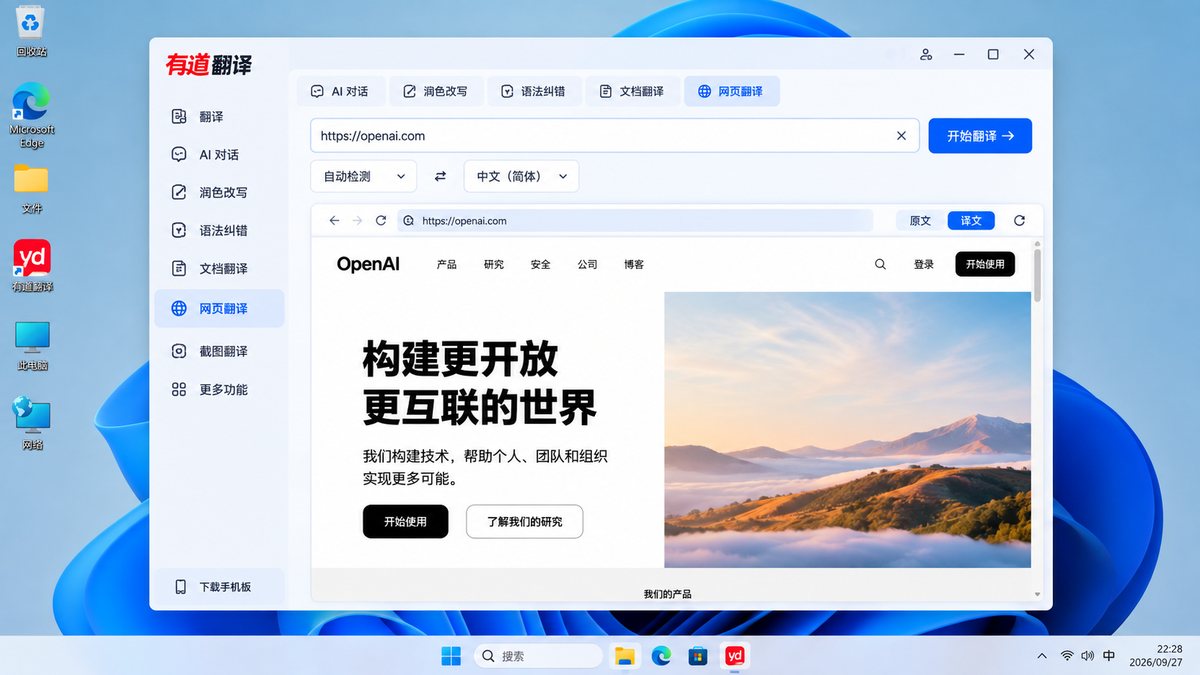
网页翻译和普通文本框翻译最大的区别,就是我还要关注“页面结构有没有被破坏”。译文即使基本正确,如果正文和导航混在一起、段落顺序错乱,实际阅读体验也会明显下降。
网页原排版能不能保持
网页翻译的一个核心价值,就是在翻译网页内容的同时尽量保留原来的页面结构。我实际判断时不会把“保持原排版”理解成每个像素都必须完全一样,而是看标题层级、正文顺序和主要阅读结构能不能继续保持。
网页本身的脚本、字体、响应式布局和第三方组件不同,翻译后局部间距或按钮位置发生变化并不奇怪。我判断结果能不能用,主要看三件事:正文顺序有没有乱、主要内容有没有漏、原文和译文还能不能顺着同一页面继续阅读。
为什么网页翻译打不开
网页翻译打不开时,我会先把问题分成“网址本身打不开”和“有道能打开入口,但目标网页加载失败”两种。两者处理方式完全不同。
| 现象 | 我先判断什么 | 下一步 |
|---|---|---|
| 粘贴网址后立即报错 | 网址格式是否完整 | 重新复制完整 https 地址 |
| 一直加载,没有进入网页 | 原网页是否能直接打开 | 先在普通浏览器测试原地址 |
| 首页能翻,点进去内容没了 | 页面是否依赖动态加载 | 单独复制最终内容页网址再测试 |
| 只能看到登录页面 | 内容是否要求账号登录 | 确认该页面是否允许未登录访问 |
| 只翻出一部分正文 | 后续内容是否滚动后才加载 | 检查是否属于动态加载页面 |
网页一直加载失败怎么排查
- 先把原网址直接粘贴到浏览器地址栏,确认网页本身可以正常访问。
- 重新复制一次完整网址,避免遗漏
https://或复制到截断地址。 - 换一个结构简单的公开网页测试,判断是不是只有当前网站失败。
- 如果简单网页能正常翻译,再检查目标页面是否需要登录或验证码。
- 如果多个公开网页都加载失败,再退出网页翻译页面重新打开,排除临时加载异常。
我通常会保留一个简单公开网页作为对照测试。只要这个对照网页可以翻译,而某一个特定网站一直失败,我就不会继续折腾客户端设置,而是优先判断目标网站本身的访问方式和页面结构。
为什么动态网页会翻译不完整
有些网页打开时并不会一次把所有正文都放进页面,而是继续通过 JavaScript 加载内容。例如滚动到页面下面才出现新段落,或者点击标签以后才加载正文。这类页面更容易出现“第一屏已经翻译,后半部分还是原文”或者“正文少了一块”的情况。
遇到这种情况,我会先区分是不是页面本身的动态加载造成的:同一个网址在普通浏览器里打开后,如果正文也需要等待、滚动或者点击以后才出现,那么网页翻译无法一次拿到全部内容就更容易发生。
如果页面有独立的文章地址或详情页,我会优先直接提交那个最终内容页的网址,而不是从包含大量异步模块的首页开始翻译。这样更容易判断正文是否能够完整加载。
为什么登录页翻译后只有一小部分内容
需要账号登录才能查看的网页,是我最容易遇到的边界场景之一。网页翻译读取网址时,不一定能继承当前浏览器里的登录状态、Cookie 或页面权限,所以即使我自己在浏览器已经登录,网页翻译拿到的仍可能只是登录页或公开部分。
这种情况下,我不会马上判断翻译功能坏了。先退出当前测试,换一个无需登录的公开网页。如果公开网页正常,就说明网页翻译功能本身还在工作,问题更可能来自目标页面的访问权限或登录状态。
为什么网页只翻译了一部分
网页只翻译一部分时,我主要看三个方向:页面后半部分是不是动态加载、正文是不是放在独立组件里、页面是否因为登录或访问限制只返回了一部分内容。
- 前半页正常、后半页缺失:优先怀疑滚动加载。
- 正文正常、某个模块完全没翻:可能是独立组件或嵌入内容。
- 只能看到简介,正文没有:检查是否需要登录。
- 换其他网页正常:更像是当前网站兼容性问题。
我不会因为某一个复杂网页失败,就马上重装有道翻译。先做对照测试通常更快:同一时间测试一个简单公开网页和一个出问题的网站,很快就能判断是整体功能异常,还是单个页面兼容问题。
什么时候不要继续用整页网页翻译
如果我的实际需求已经不是“读整个网页”,我就不会继续强行使用网页翻译。比如只需要处理网页里的一小段普通文字,可以转到本站的 有道翻译划词翻译 教程。这里不展开划词操作,避免把两个不同任务混在一起。
我最后会做的网页翻译检查
- 网址是否是完整的 https 地址。
- 原网页是否能在普通浏览器正常打开。
- 网页翻译后主标题和正文是否都出现。
- 长页面往下滚动以后是否还有译文。
- 正文顺序是否基本保持。
- 页面是否要求登录、验证码或额外权限。
- 失败时是否已经用一个简单公开网页做过对照测试。
我判断网页翻译是否正常,不会只看“有没有出现译文”这一点。真正能用的结果应该是:网址能加载、正文基本完整、页面结构没有严重错乱,而且我能顺着原网页继续阅读。如果只有某个动态页面或登录页失败,而普通公开网页都正常,我会把它判断为页面兼容或访问权限问题,而不是整个网页翻译功能失效。